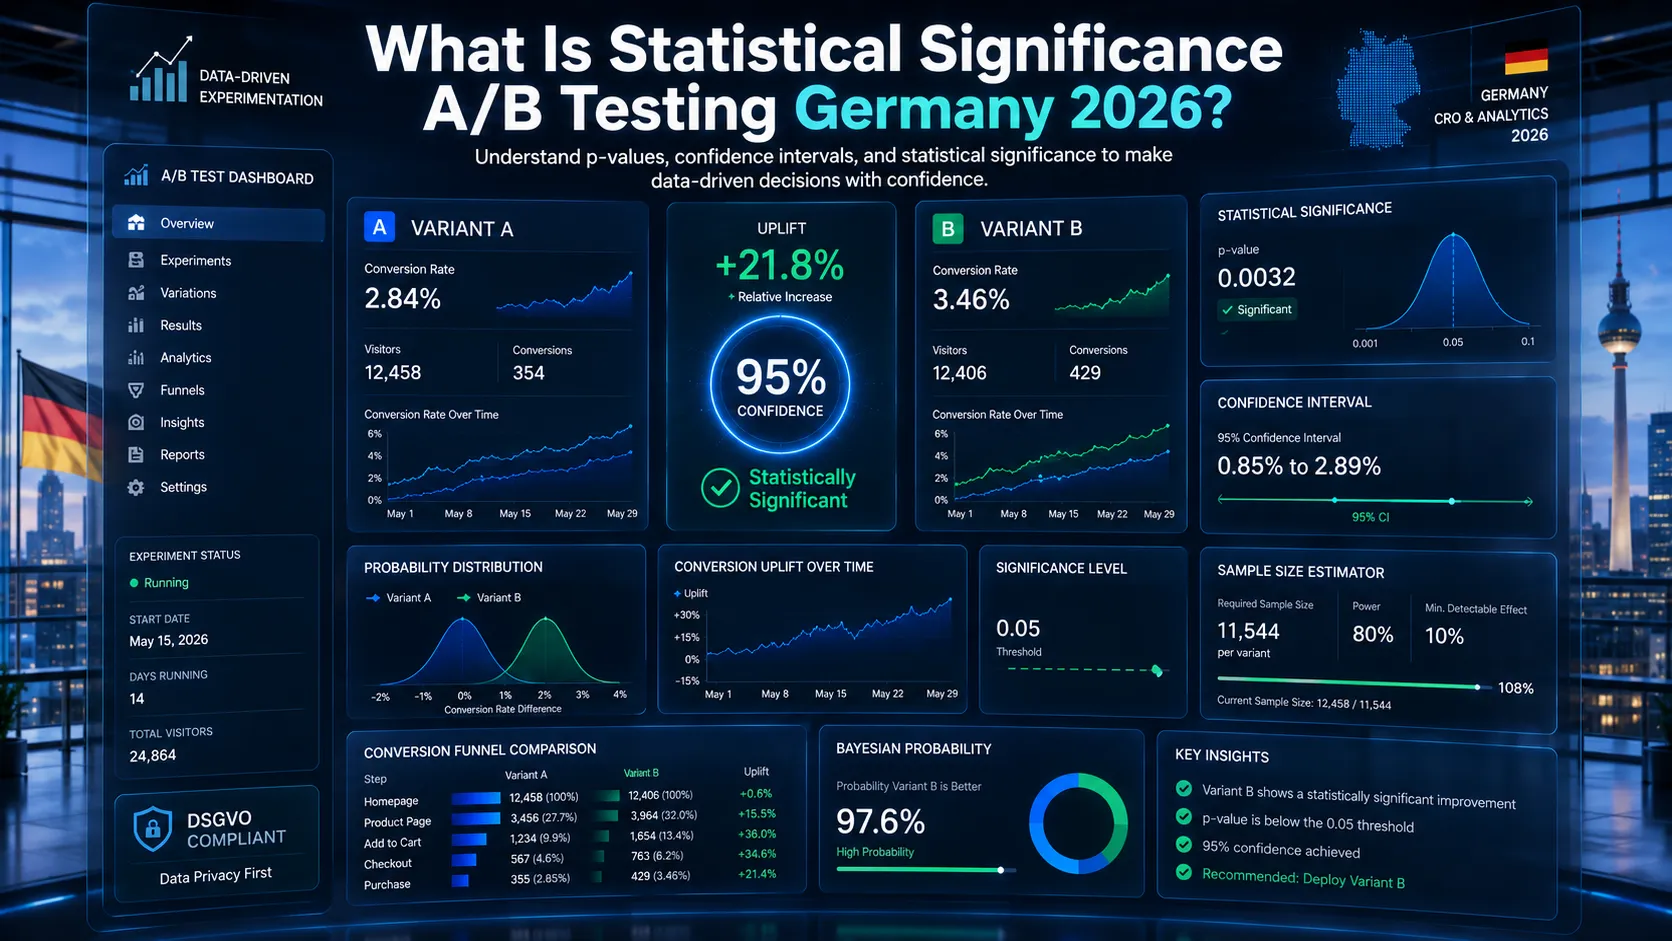
An der statistischen Signifikanz scheitern viele A/B-Testing-Programme in Deutschland. Tests werden zu früh beendet, p-Werte falsch gedeutet, Stichprobengrößen ignoriert. Das Ergebnis: falsch positive Gewinner, deren Effekt nach der Umsetzung verschwindet. Echte Conversion-Optimierung erfordert statistische Disziplin – ohne sie führen Sie zwar Tests durch, treffen Entscheidungen aber auf Basis von Zufallsrauschen.
Dieser Ratgeber zeigt, was statistische Signifikanz beim A/B-Testing 2026 tatsächlich bedeutet: p-Werte in einfachen Worten, Methodik der Stichprobengröße, Konfidenzintervalle, typische Fehler und praxisnahe Leitlinien.
Einen Überblick zum A/B-Testing finden Sie in unserem Ratgeber zum A/B-Testing.
Was ist statistische Signifikanz?
Einfach erklärt:
Die Frage
Wenn Variante B in einem Test besser konvertiert als Variante A: Ist B wirklich besser – oder ist das nur Zufall?
Statistische Signifikanz
Sie gibt an, wie sicher Sie sein können, dass der Unterschied echt und nicht zufällig ist.
Übliche Schwelle
p < 0,05 = 5 % Wahrscheinlichkeit, dass das Ergebnis zufällig ist. 95 % Konfidenz, dass das Ergebnis echt ist.
Praktische Deutung
p < 0,05: Gewinner mit hinreichender Sicherheit bestimmen. p > 0,05: Ergebnis nicht statistisch signifikant. Treffen Sie darauf keine Entscheidungen.
Was ist ein p-Wert?
Die am häufigsten missverstandene Kennzahl im A/B-Testing:
Definition
Der p-Wert ist die Wahrscheinlichkeit, dieses (oder ein noch extremeres) Ergebnis zu beobachten, wenn es tatsächlich keinen Unterschied zwischen den Varianten gibt.
Einfacher gesagt
Wie wahrscheinlich ist es, dass der Zufall dieses Ergebnis hervorgebracht hat?
Beispiele
- p = 0,04: 4 % Wahrscheinlichkeit, dass der Zufall diesen Unterschied erzeugt hat. Wahrscheinlich echt.
- p = 0,50: 50 % Wahrscheinlichkeit für Zufall. Kein Ergebnis.
- p = 0,001: 0,1 % Wahrscheinlichkeit für Zufall. Sehr starkes Signal.
Häufige Fehldeutungen
- „p = 0,04 bedeutet, dass Variante B mit 96 % Wahrscheinlichkeit besser ist.“ → FALSCH
- „p = 0,04 bedeutet, dass das Ergebnis mit 4 % Wahrscheinlichkeit falsch ist.“ → FALSCH
Der p-Wert sagt etwas über die Wahrscheinlichkeit des Ergebnisses unter der Nullhypothese aus – nicht direkt über die Wahrscheinlichkeit eines echten Effekts.
Was ist ein Konfidenzintervall?
Die Bandbreite plausibler tatsächlicher Effekte:
Beispiel
Der Test zeigt bei Variante B eine um 15 % höhere Conversion. 95-%-Konfidenzintervall: 5 % bis 25 % Steigerung.
Deutung
Die tatsächliche Steigerung liegt mit 95 % Konfidenz zwischen 5 % und 25 %.
Warum das wichtig ist
Ein „gewonnener“ Test mit einem Konfidenzintervall von −5 % bis +25 % bedeutet, dass der tatsächliche Effekt auch negativ sein könnte. Das ist kein eindeutiger Gewinner.
Aussagekräftiger als der p-Wert allein
Das Konfidenzintervall zeigt die Unsicherheit. Der p-Wert sagt nur „signifikant oder nicht“.
Wie berechnen Sie die Stichprobengröße?
Drei Eingaben sind nötig:
Aktuelle Conversion-Rate
Der Ausgangswert. Beispiel: 2,5 %.
Minimal nachweisbarer Effekt
Die kleinste relevante Verbesserung. Beispiel: 10 % relative Steigerung = Verbesserung auf 2,75 %.
Statistische Power
Die Wahrscheinlichkeit, dass der Test einen echten Effekt erkennt, wenn es ihn gibt. Meist 80 %.
Dazu das Konfidenzniveau
Meist 95 %.
Formel für die Stichprobengröße
Online-Rechner (Evan Miller, Optimizely, VWO). Werte eintragen, fertig.
Beispielrechnung
Ausgangswert 2,5 %, minimaler Effekt 10 % relativ, 95 % Konfidenz, 80 % Power = ca. 30.000 Besucher pro Variante.
Ab welcher Stichprobengröße lohnt sich A/B-Testing?
Kleine Website (unter 100.000 Besucher pro Monat)
Realistisch nachweisbarer Mindesteffekt: 20–30 %. Testen Sie größere Änderungen.
Mittelgroße Website (100.000–500.000 Besucher pro Monat)
Effekte von 10–20 % sind nachweisbar.
Große Website (über 500.000 Besucher pro Monat)
Effekte von 5–15 % sind nachweisbar.
Folgen
Websites mit wenig Traffic müssen größere Änderungen testen. „CTA um 10 Pixel verschieben“ wird kaum Signifikanz erreichen.
Wie lange sollten Tests laufen?
Zwei Voraussetzungen:
Statistische Stichprobengröße erreicht
Beenden Sie den Test nicht vorher.
Mindestdauer zur Abdeckung von Zyklen
- Eine volle Woche (Wochentage + Wochenende)
- B2B: eine volle Geschäftswoche
- Einschließlich Geschäftszyklus (z. B. monatlicher Vertriebszyklus, falls relevant)
Maximum
6 Wochen, bevor externe Faktoren die Ergebnisse verzerren. Feiertagssaisons stören besonders stark.
Faustregel
Für typische mittelgroße deutsche Websites: 2–4 Wochen pro Test.
Welche Statistikfehler passieren häufig?
Sieben Fehler:
Tests zu früh beenden
„Variante B nach 3 Tagen bei 95 % Konfidenz!“ Oft ein falsch positives Ergebnis. Warten Sie, bis die Stichprobengröße erreicht ist.
P-Hacking
20 Kennzahlen betrachten und diejenige berichten, die Signifikanz erreicht. Eine Bonferroni-Korrektur ist nötig.
Stichprobengröße ignorieren
Einen Gewinner mit 100 Besuchern pro Variante ausrufen. Zu wenige Daten.
Nicht signifikant als „kein Unterschied“ deuten
Nicht signifikant bedeutet „ohne Ergebnis“, nicht „kein Effekt“.
Segmente herauspicken
„Der Test ist insgesamt gescheitert, aber bei mobilen Nutzern in Berlin hat er gewonnen!“ Das ist statistisches Fischen.
Problem multipler Vergleiche
50 Tests mit 5 % Falsch-positiv-Rate ergeben erwartungsgemäß 2–3 falsche Gewinner. Passen Sie die Signifikanzschwelle an.
Statistische mit praktischer Signifikanz verwechseln
5 % Steigerung können statistisch signifikant sein – bringen sie aber nur 100 € pro Jahr, ist das bedeutungslos.
Bayesianisch oder frequentistisch?
Zwei statistische Ansätze:
Frequentistisch (klassisch)
p-Werte, Signifikanzschwellen. Standard in den meisten Testing-Tools.
Bayesianisch
Berechnet die Wahrscheinlichkeit, dass eine Variante besser ist, und aktualisiert sie laufend mit neuen Daten.
Vorteile des frequentistischen Ansatzes
Gut verstanden, Branchenstandard, von den meisten Tools unterstützt.
Vorteile des bayesianischen Ansatzes
Intuitives Ergebnis („87 % Wahrscheinlichkeit, dass Variante B besser ist“). Zwischenergebnisse lassen sich ohne statistische Nachteile ansehen.
Stand 2026
Die meisten Testing-Tools bieten beides. Entscheiden Sie nach Erfahrung des Teams und statistischer Präferenz.
Für die meisten deutschen Unternehmen ist der frequentistische Ansatz (95 % Konfidenz, p < 0,05) Standard und gut unterstützt.
Wie beeinflusst der deutsche Markt die Statistik?
Drei Faktoren:
Niedrigere Conversion-Raten
Der deutsche Markt hat bei gleichen Produkten niedrigere Conversion-Raten als der US-Markt. Für denselben Effekt ist daher eine größere Stichprobe nötig.
Stichprobenverzerrung durch das Cookie-Banner
Nutzer, die alle Cookies ablehnen, werden unter Umständen nicht erfasst. Eine Verzerrung der Stichprobe ist möglich. Dokumentieren und berücksichtigen Sie das.
Eingeschränktes geräteübergreifendes Tracking
DSGVO und Tracking-Beschränkungen der Browser erschweren es, Nutzer über Geräte hinweg zu verfolgen. Teilweise Vermischung der Testgruppen ist möglich.
Welche Statistikfunktionen bieten Testing-Plattformen?
Integrierte Signifikanzrechner
VWO, Optimizely und Convert berechnen p-Werte und Signifikanz automatisch.
Stichprobenrechner
In den meisten Plattformen enthalten. Einige extern (Evan Miller ist weit verbreitet).
Bayesianische Optionen
Zunehmend verfügbar, in den meisten Plattformen optional.
Konfidenzintervalle
Moderne Plattformen zeigen sie an. Nutzen Sie sie und schauen Sie nicht nur auf p-Werte.
Welches Statistikwissen brauchen CRO-Teams?
Fünf Konzepte, die Sie beherrschen sollten:
Statistische Signifikanz
p-Werte, Konfidenzniveaus und was sie bedeuten.
Stichprobengröße
Wie man sie berechnet und warum sie wichtig ist.
Effektgröße
Praktische vs. statistische Signifikanz.
Multiple Vergleiche
Bonferroni, FDR und warum viele gleichzeitige Tests eine Korrektur erfordern.
Konfidenzintervalle
Die Bandbreite wahrscheinlicher tatsächlicher Effekte.
Ohne dieses Wissen produziert zufälliges Testen zufällige „Gewinner“.
Häufige Fragen zur statistischen Signifikanz beim A/B-Testing
Die Wahrscheinlichkeit, dass das beobachtete Ergebnis zufällig entstanden ist. p < 0,05 = signifikant.
95 % als Standard. 99 % bei hoher Tragweite. Nicht unter 90 %.
Mit Online-Rechnern. Eingaben: aktuelle Conversion-Rate, minimaler Effekt, Konfidenz, Power.
Nein. Ein vorzeitiger Abbruch erhöht die Falsch-positiv-Rate erheblich. Warten Sie, bis die Stichprobengröße erreicht ist.
Viele Kennzahlen betrachten und diejenige berichten, die Signifikanz erreicht. Korrigieren Sie für multiple Vergleiche.
Frequentistisch ist Standard, bayesianisch ist intuitiver. Die meisten Tools bieten beides. Wählen Sie, was Ihr Team versteht.
Länger laufen lassen, um mehr Daten zu sammeln, oder das offene Ergebnis akzeptieren. Erzwingen Sie keine Interpretation.
Statistisch = das Ergebnis ist echt. Praktisch = das Ergebnis ist für das Geschäft relevant. Für eine sinnvolle Änderung braucht es beides.
Sie brauchen Unterstützung bei der Teststatistik?
Wenn Sie eine Testmethodik für Ihr Unternehmen aufsetzen und in einem 30-minütigen Gespräch statistische Sorgfalt und Stichprobenplanung klären möchten, buchen Sie einen Termin oder senden Sie uns Ihre Eckdaten über unsere Kontaktseite.
Sie brauchen fachkundige Unterstützung? Gem Programmers bietet Conversion-Optimierung für Unternehmen in Deutschland, Österreich und der Schweiz. Fordern Sie ein kostenloses, unverbindliches Angebot an und erhalten Sie einen klaren Plan mit Umfang, Zeitrahmen und Preis.